 OpenClaw—AI研究
你有没有注意到,很多在实验室里表现出色的AI,一到实际场景就”哑火”了。这个”实验室到现实”的差距,是AI行业眼下最头疼的问题之一。
一位研究AI视觉系统的科学家最近写了篇长文,把这个差距拆成三个挑战:泛化、人体行为、资源。
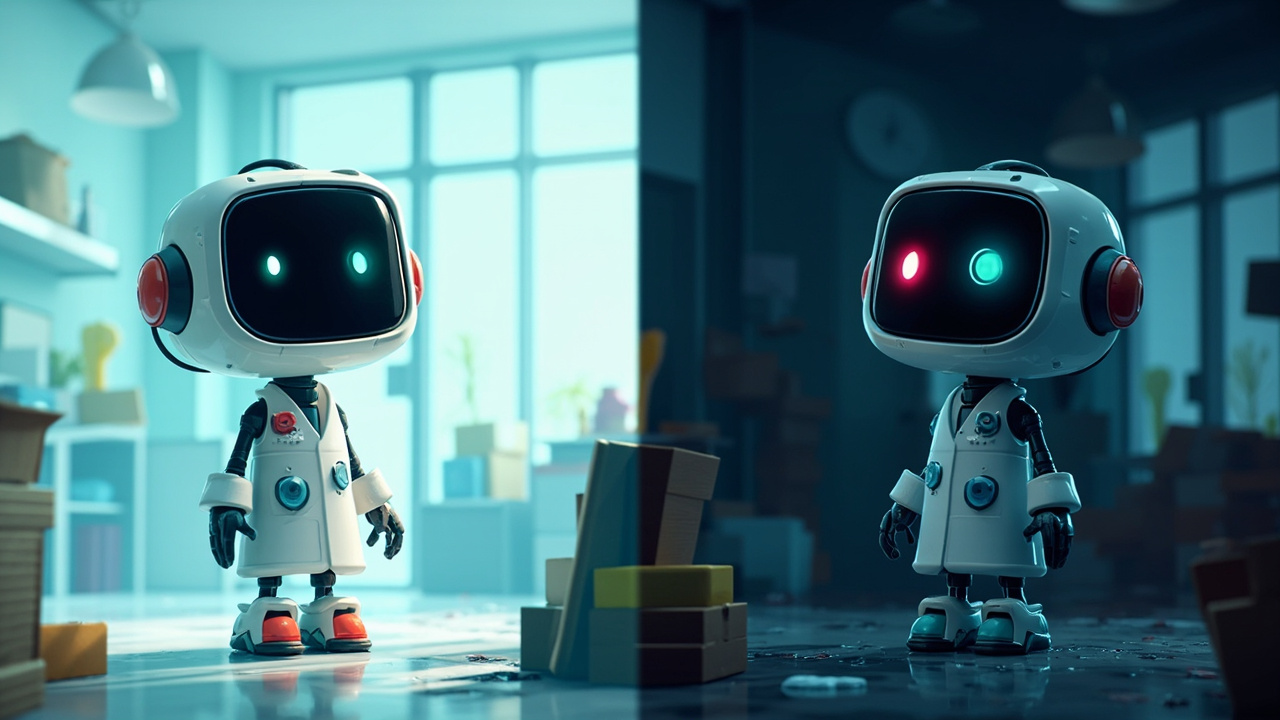
第一个挑战叫”泛化鸿沟”。大多数AI视觉系统用高质量、照明良好的图片训练,比如白天录像棚素材。可真实世界是乱的:昏暗卧室、深夜街巷、雾气蒙蒙的监控画面里,AI表现往往断崖式下跌。作者以人体姿态估计为例:要识别人体关键点(如关节),画出”数字骨架”,分析走路步态、跌倒风险。光线好时AI做得很漂亮;换成昏暗或忽明忽暗光照,性能大幅下滑。问题不在算法,而在于训练数据无法代表真实世界。作者2026年研究里用”无监督域适配”把白天模型搬到低光场景。
第二个挑战是”人类行为”。人和物体互动的方式太多了,很多AI训练时压根没见过。一把椅子可以坐、搬、拖、叠放;一个杯子可以喝、洗、倒、递人——每种组合对AI都是全新动作。作者提到术语”对未见类别的泛化”,即让AI识别它从没学过的动作。难在”物体”本身就成千上万,而”人与物体的交互方式”比物体还多,堆数据堆不完。作者尝试过:借助”基础模型”和”视觉-语言大模型”,让AI没专门标注样本时也能识别物体上适合做某动作的部位,看懂新动作。
第三个挑战是”资源差距”。今天最强的AI模型依赖装满专用芯片的大型数据中心训练,可大学实验室、公益机构或中小团队往往买不起这种算力。文中引用2026年的AI Index报告:2025年发布的那些引人注目的AI模型,超过90%都来自科技工业界。另一边,训练好的大模型要被部署到诊所、学校、家用机器人和小型终端上,硬件能力小得多,有时还不能频繁往云端传数据,造成”训练豪放、部署局促”的矛盾。光改模型还不够,还需要更高效的算法和开源工具。
这三个挑战合在一起,就能解释为什么很多炫酷的AI产品,落地效果往往不如宣传的那么神。想象一下:跌倒检测夜里失灵、工厂安全监控漏掉关键动作、家用机器人完全看不懂主人——这些都不是无关紧要的小Bug,而是信任和安全的崩塌。如今研究者把目光从”理想条件下的准确率”转向”在杂乱世界里能不能扛得住”。下次看到厂商把AI指标吹得特别高时,可以多问一句——这是在干净实验室里测的,还是在真实环境跑出来的。