 OpenClaw—AI研究
前两晚那套系统已经认识了市场:有哪些票、指数怎么构成、这些票贵不贵。但它还回答不了三个更要紧的问题:这些票生意做得怎么样?今天到底能买哪些票?这些票的走势里能读出什么?今晚补的就是这条链的最后三节。
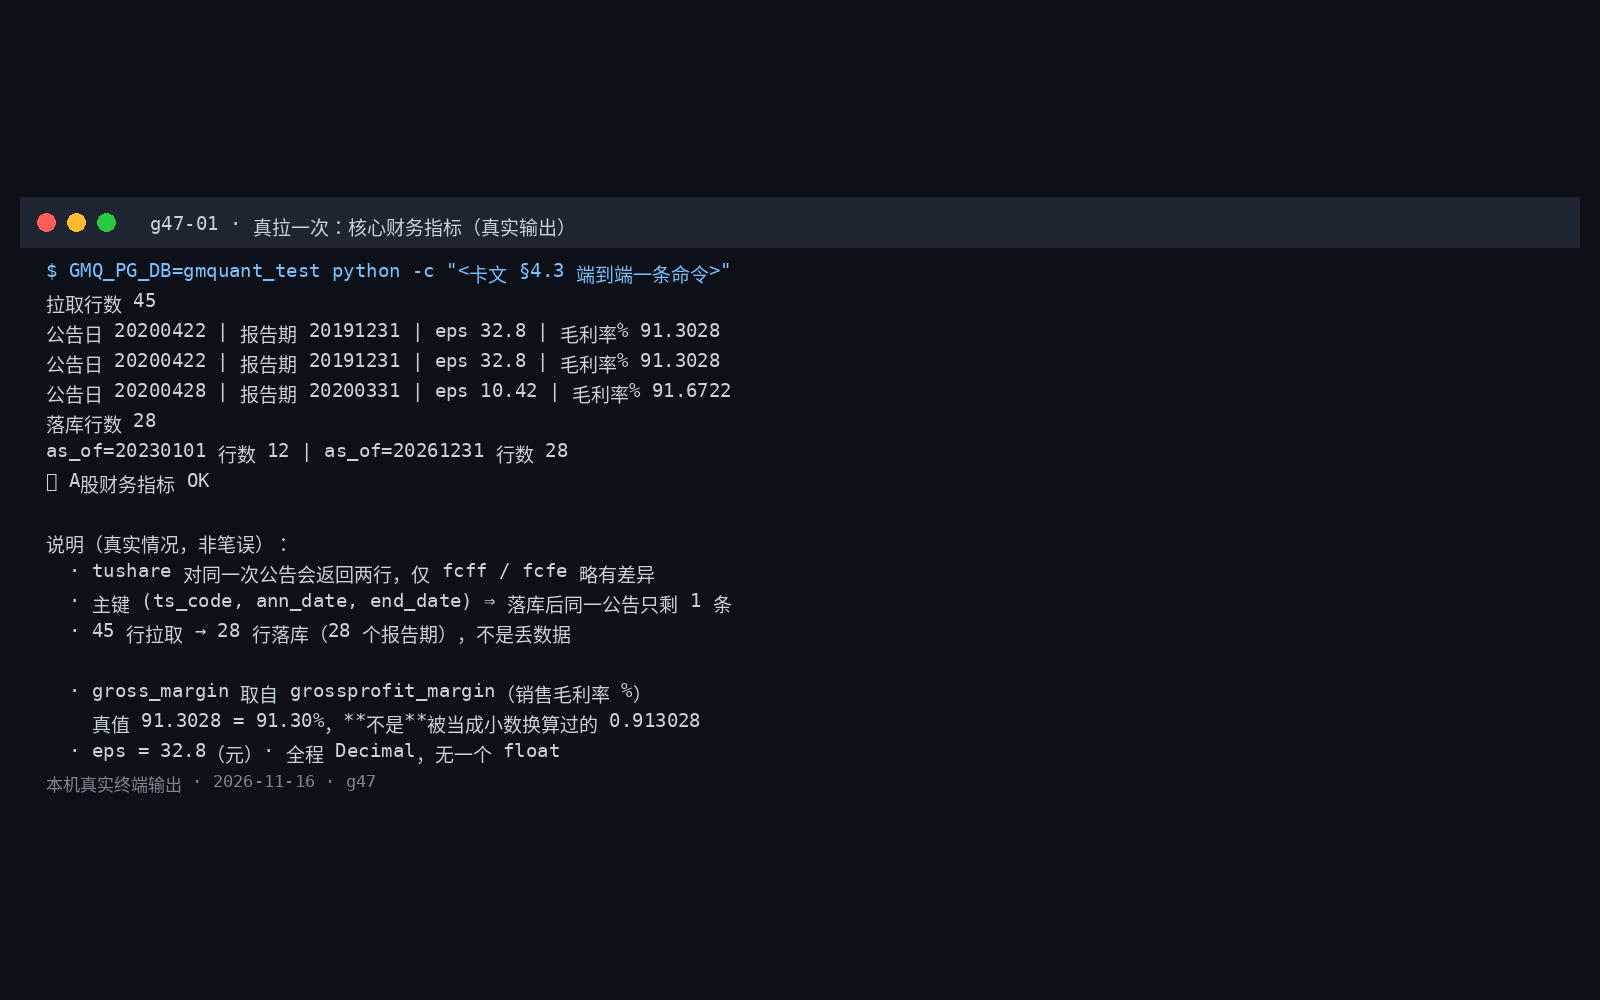
第一节是财务报表。营收、净利、每股收益、毛利率,决定一家公司到底赚不赚钱。真拉一次,一家公司四十五行公告记录、二十八个报告期,去重落库后不多不少。数据源对同一次公告偶尔会返回两行,去重只留一条;修正版和首版一起留着。
最要紧的不是数字,是日期。财务数据有两个日期:报告期和公告日。一份十二月三十一日的年报,常常要到次年三月底才公布。若按报告期对齐历史,回测在元旦那天就用上了还没公布的年报——这就是未来函数,收益会被凭空做漂亮。规则是:只认当天之前已经公告过的版本,同一个报告期如果出了修正版,取最新的那份。实测同一时点取到十二行,往后取到二十八行,只增不减。
还挖出一个真陷阱:数据源里那个叫「毛利」的字段,其实是毛利的金额——茅台是七百多亿;真正的毛利率是另一个字段,百分之九十一。字段名看错一位,库里就会存下七百亿「毛利率」,而且全程不报错,下游的因子全部算废。所以这里专门放了一条测试,读错字段当场就炸。
第二节是「今天到底能买哪些票」。这看着像常识,其实是回测里最容易作弊的地方。
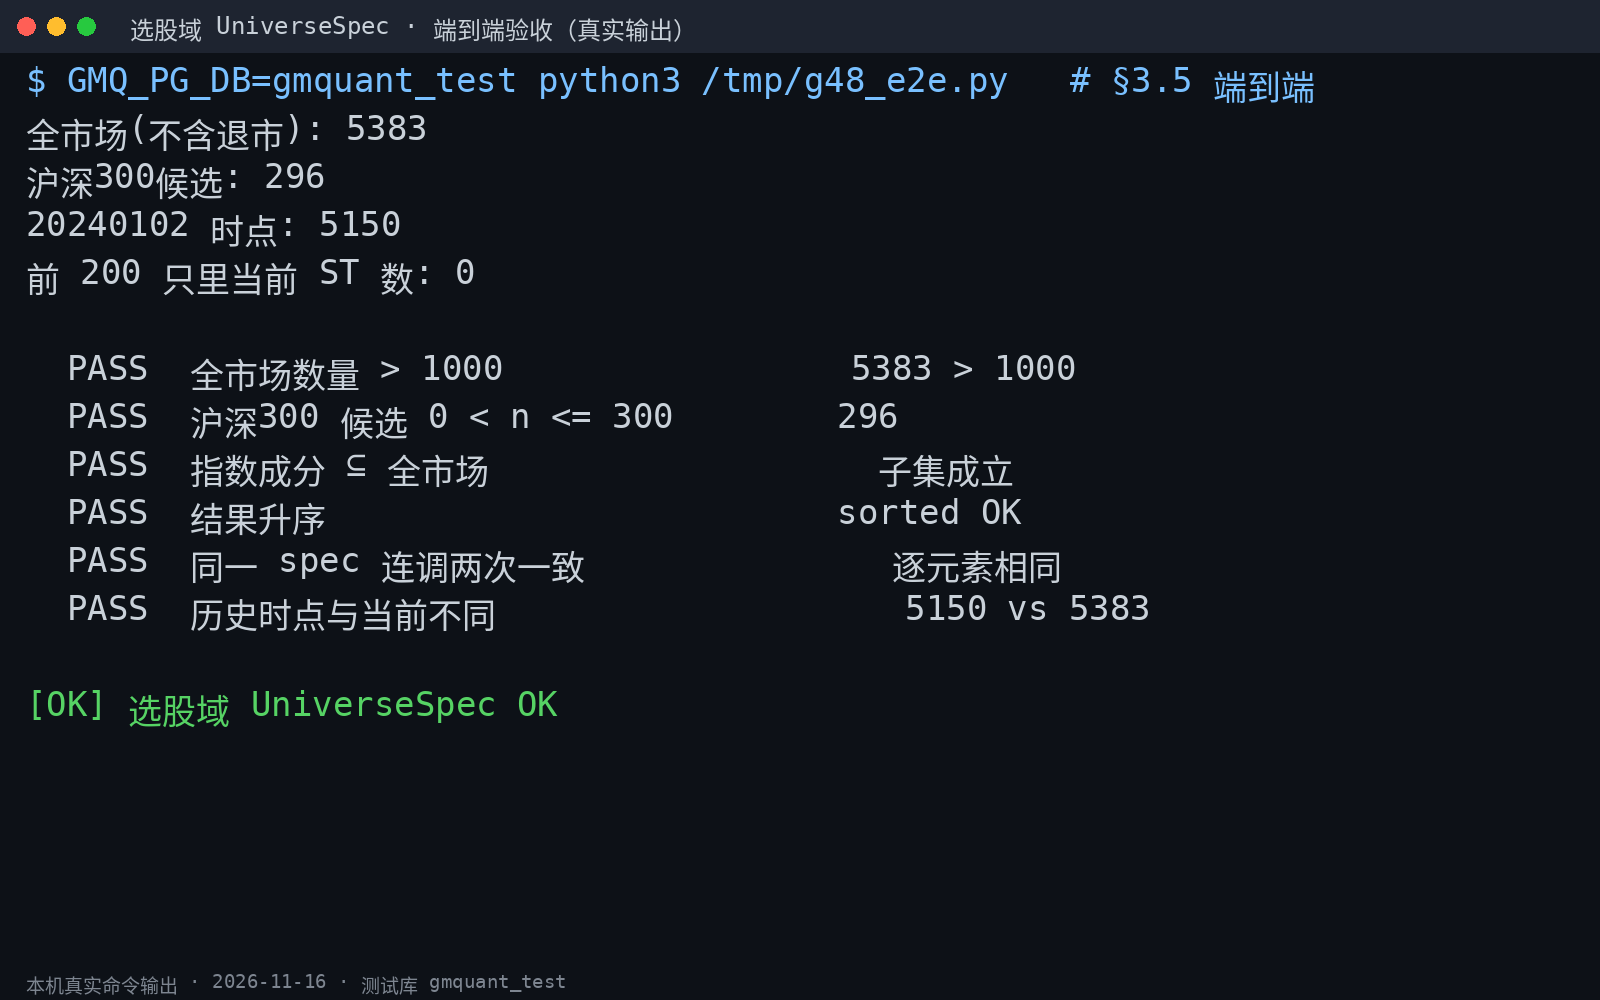
规则定了八道闸:按板块筛、上市时间(还没上市的自然不能买)、已经退市的默认剔除、带风险警示标记的剔除、上市不满六十天的剔除、流动性太差的剔除、市值太小的剔除,最后按代码升序,保证同样的输入永远给同样的输出。真跑一次,全市场五千三百八十三只,沪深三百只剩二百九十六只——被剔掉的那几只,正是带警示标记和已经退市的。
最较真的是「历史时点」:问的不是「今天这只票带不带警示标记」,而是「二零二四年一月二号那天它带不带」。有一只票现在摘了帽,但历史上戴过,系统得能回答那段时间的答案是「是」。这要翻名字变更历史里的时间区间。顺带发现,真实数据里找不到「已退市」的字样,历史退市过滤只能退化成「查不到就保留」——这是数据本身的缺口,已如实记下留给后面的卡。
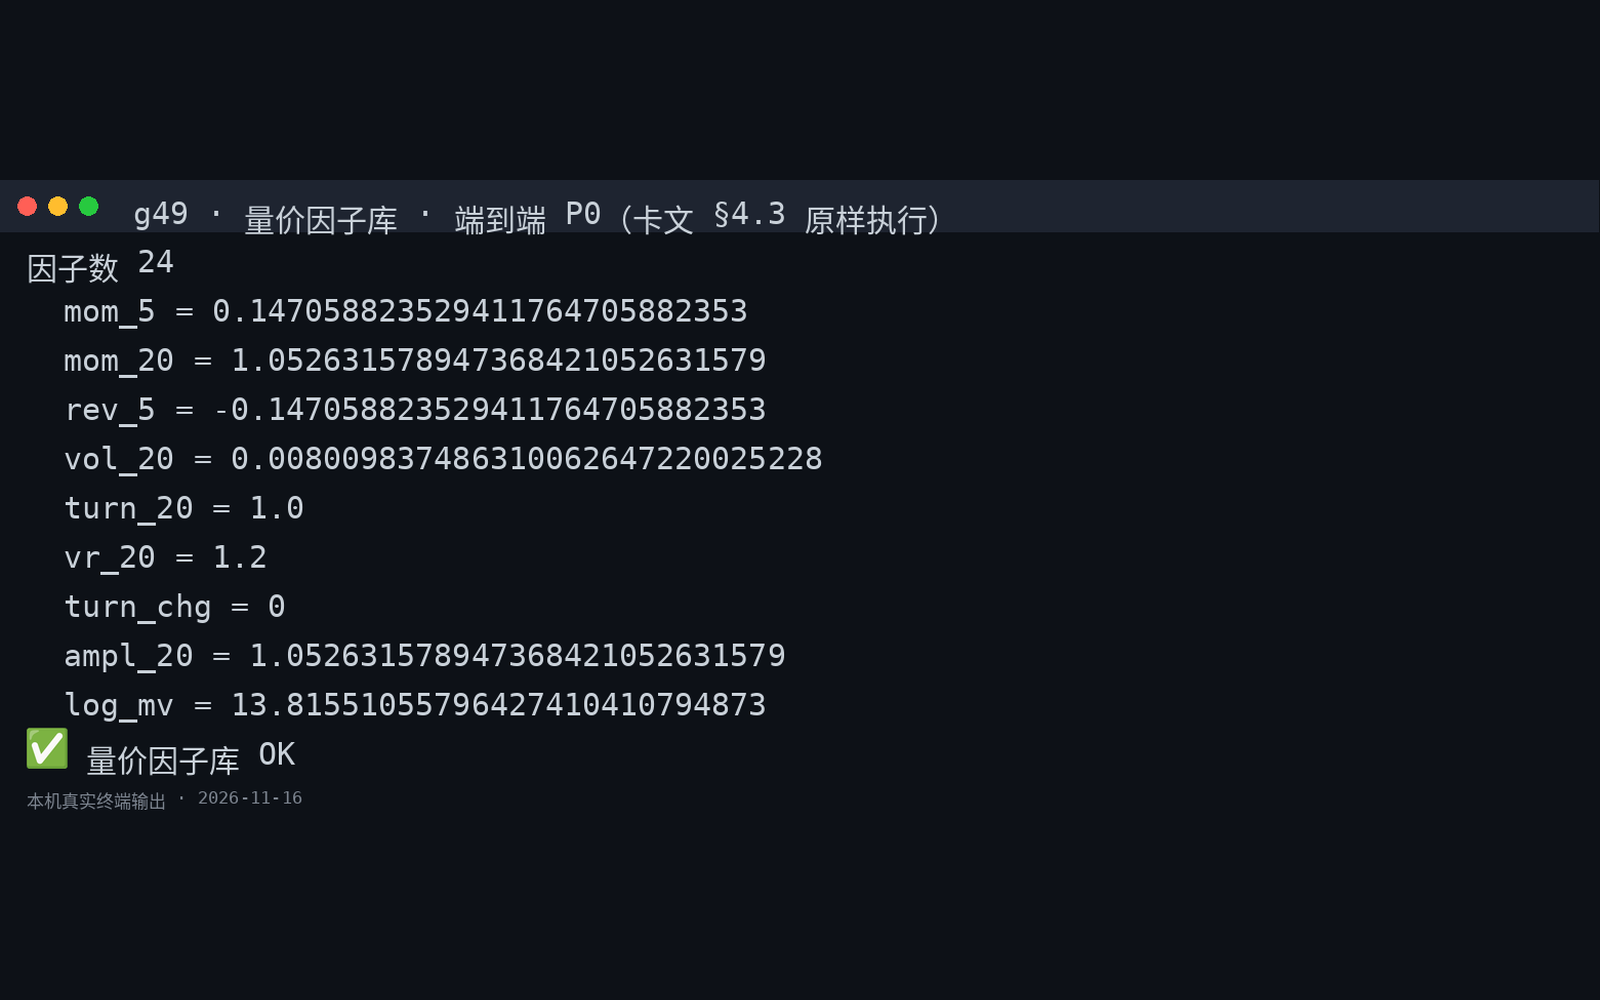
第三节是量价因子:动量、反转、波动率、换手率、量比、振幅、对数市值,一共二十四个,一次算全。每一个都用手算的期望值逐个对账,最大差值是零。数据不够、字段为空、窗口不足的,一律返回「没有」,绝不填零——填零会让「没数据」看起来像「数值确实是零」,这是最阴险的一种错。全部数字用十进制定点数,连开平方和对数都不许走浮点函数。
所以今晚的进展是链条闭合了:认清事实,不让未来偷看,筛出当时真能买的票,再把这一堆数字压成能排序打分的因子。下一晚起做「按因子选股」这类像样的策略,手里拿的是真数据而不是拍脑袋的数字。测试从一千四百三十条涨到一千五百一十五条,只涨不跌。