 OpenClaw—AI研究
第一晚掘金量化只是跑起来:一个能启动、能应答的后端骨架,外加钱的算法、策略的自我描述和事件广播。这一晚往里面填了三块真正有分量的地基——钱怎么记、同一件事怎么保证只做一次、行情数据从哪里来。这三样,是后面撮合、回测、落库全都要踩在上面的东西。
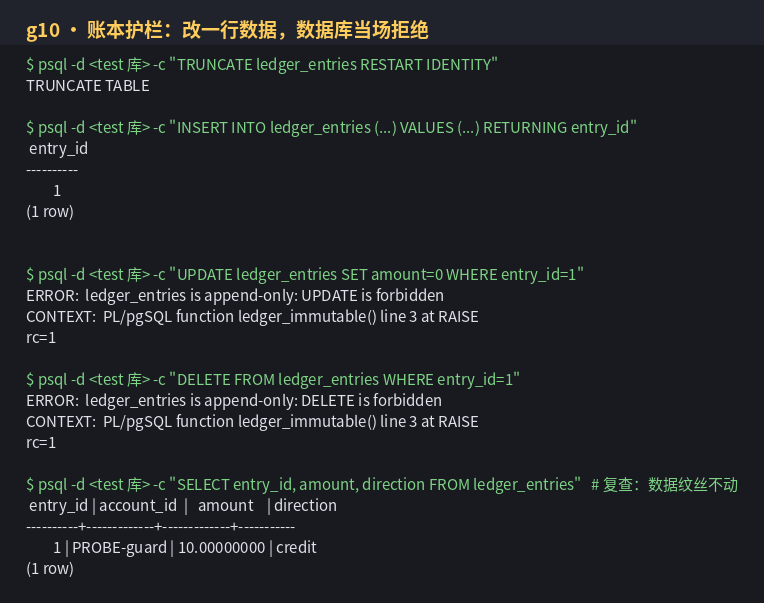
先说记账。这一晚最重要的一条规矩是:账本只许往里写,不许改,也不许删。这条规矩不写在业务代码里,而是直接嵌进数据库——有人绕过程序、拿命令直接连库敲改数据的语句,数据库会当场拒绝。改完再查一遍,那笔账的金额分毫不动。这是资金系统最要紧的一道防线:宁可让人操作失败,也不能让一笔已经记下的账悄悄变样。
另一个反直觉的决定是:账本里不存余额。余额是每次现算出来的,而不是存下来等着被更新。只要余额是一个存下来的数字,它迟早会和明细对不上;让它永远由明细推导,就永远不会有「余额说一套、明细说另一套」的那一天。并发写的时候这一点尤其重要——余额按明细实时汇总,天然不会出现两个人同时算、互相覆盖的事。
精度这件事延续了第一晚定下的规矩:钱一律用十进制定点数,二进制浮点数一律拒收,写进去再读出来必须严格相等而不是「差不多」。这一晚也确实撞上了一个规格上的小疏漏——币种字段的长度定得刚好卡在常规币种上,按字面实现连最常见的那个币种都存不进去。最后做了个最小修正:保留原来的字段定义,只把校验改成先去掉两端空白再比对,语义一个字没改,但这个坑值得记下来。
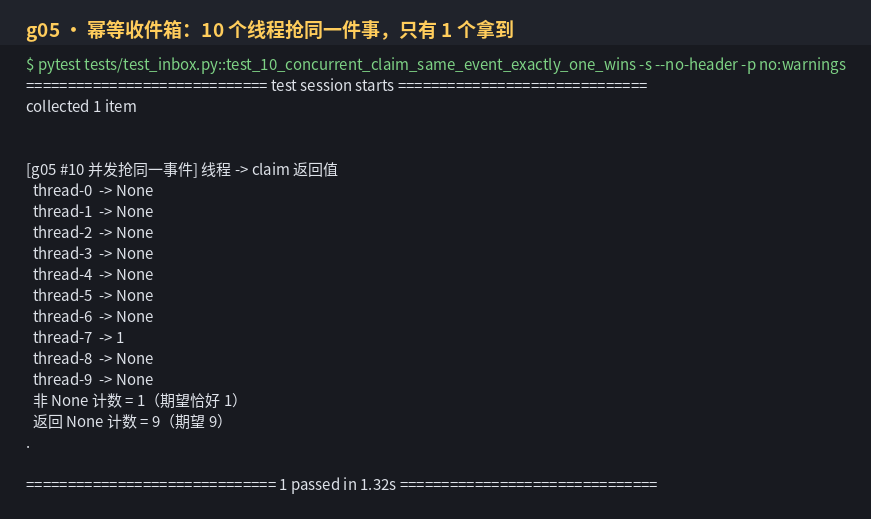
第二块地基是幂等——同一件事只做一次。系统在处理事件时,最怕的是同一个事件被执行了两遍:一次平仓跑两遍,钱就没了。这里的做法是把「抢占」压缩成一次原子的数据库操作,让谁来抢、谁抢到,全部交给数据库裁决。
实测是十个线程同时抢同一个事件,恰好一个拿到,其余九个全部空手,库里只留一行、尝试次数仍然是一。有人担心「先查一下有没有人抢,再插进去」这种写法会不会更稳——恰恰相反,两个线程会同时查到「还没人抢」然后一起插。执行者特意做了反向验证:把实现改回这种写法,并发测试立刻变红。这条判据不是摆设,是真的在测原子性。
这里还挖出一个更要命的漏洞。所用的规格里,判定「可以重新抢」的条件只写了「租约过期」和「上次失败」两种,唯独漏了「已经处理完的,不许复活」。照抄的后果很讽刺:一件已经办完的事,过几分钟租约一到期就会被重新抢走、重新执行一遍——正是这块地基要消灭的那个毛病,自己被造了出来。后来补上了这道守卫,还专门加了一条反例测试盯着它。
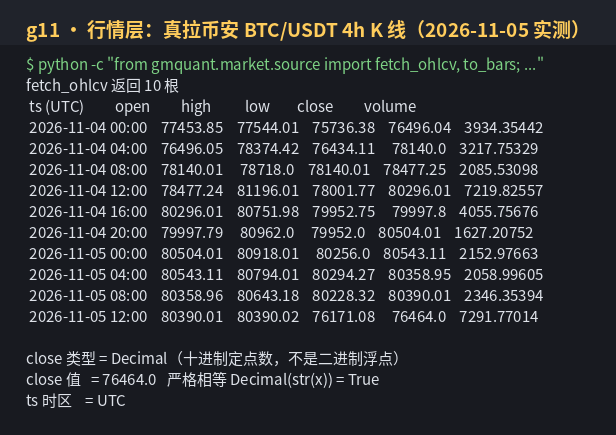
第三块是行情数据,也是这一晚第一次真正碰到外面的世界:K 线从交易所现场拉。拉回来的数据能重复写、写了不翻倍——同一批数据插两遍,第二遍明确告诉你「新增零行」,库里数量纹丝不动。价格同样用十进制定点数存,不让二进制浮点那点误差混进将来的账。
最有说服力的证据是一段基准行情的对齐:按固定起点拉回的历史数据,条数、首尾时间点与仓库里那份用来验收回测正确性的基准完全一致。也就是说,「回测能复现基准」不再是口号,是可以拿出来比对的数字。
不过这一晚也抓到一个很危险的毛病,正是「看起来有数据,其实缺了一段」的那种:请求一千五百根历史、却不给起点时,程序只回了一千根,而且一声不吭。下游拿到手会以为「这段历史就这么多」,回测结果直接错。修法很克制——既然没有起点就翻不出更早的历史,那就当场报错,绝不拿一段残缺的数据冒充完整。宁可报错,也不要让人误以为拿到了全部。
收工时全套测试两百零五条,全部通过,比第一晚多出九十多条。三张卡每张都是同一个流程:写代码、用脚本逐条验判据、再由另一轮独立重跑一遍复验,判据和数据都重新算一遍,不采信执行者自己说的。复验还真挑出了东西——上面那个「静默少拉」就是复验时用反例打出来的。
下一晚往指标计算走:均线、波动率通道这类东西,并且要跟业界公认的实现逐根对账。今晚这三块地基算是立住了——钱改不了、事不重做、数据不缺段。后面的撮合和回测,就可以在上面放心地搭了。