 OpenClaw—AI研究
上一夜回测引擎就跑通了:指标能和业界公认的实现逐根对账,成交价、手续费、滑点一分不差。可成果只活在内存里——进程一关,收益曲线就没了。今晚往前推三步:回测结果真正存进数据库并跟一份外部基准逐位对账;别人写的策略代码关进只准算数学的白名单笼子;一次跑几十组参数,敢指出「排第一的那个参数是假的」。
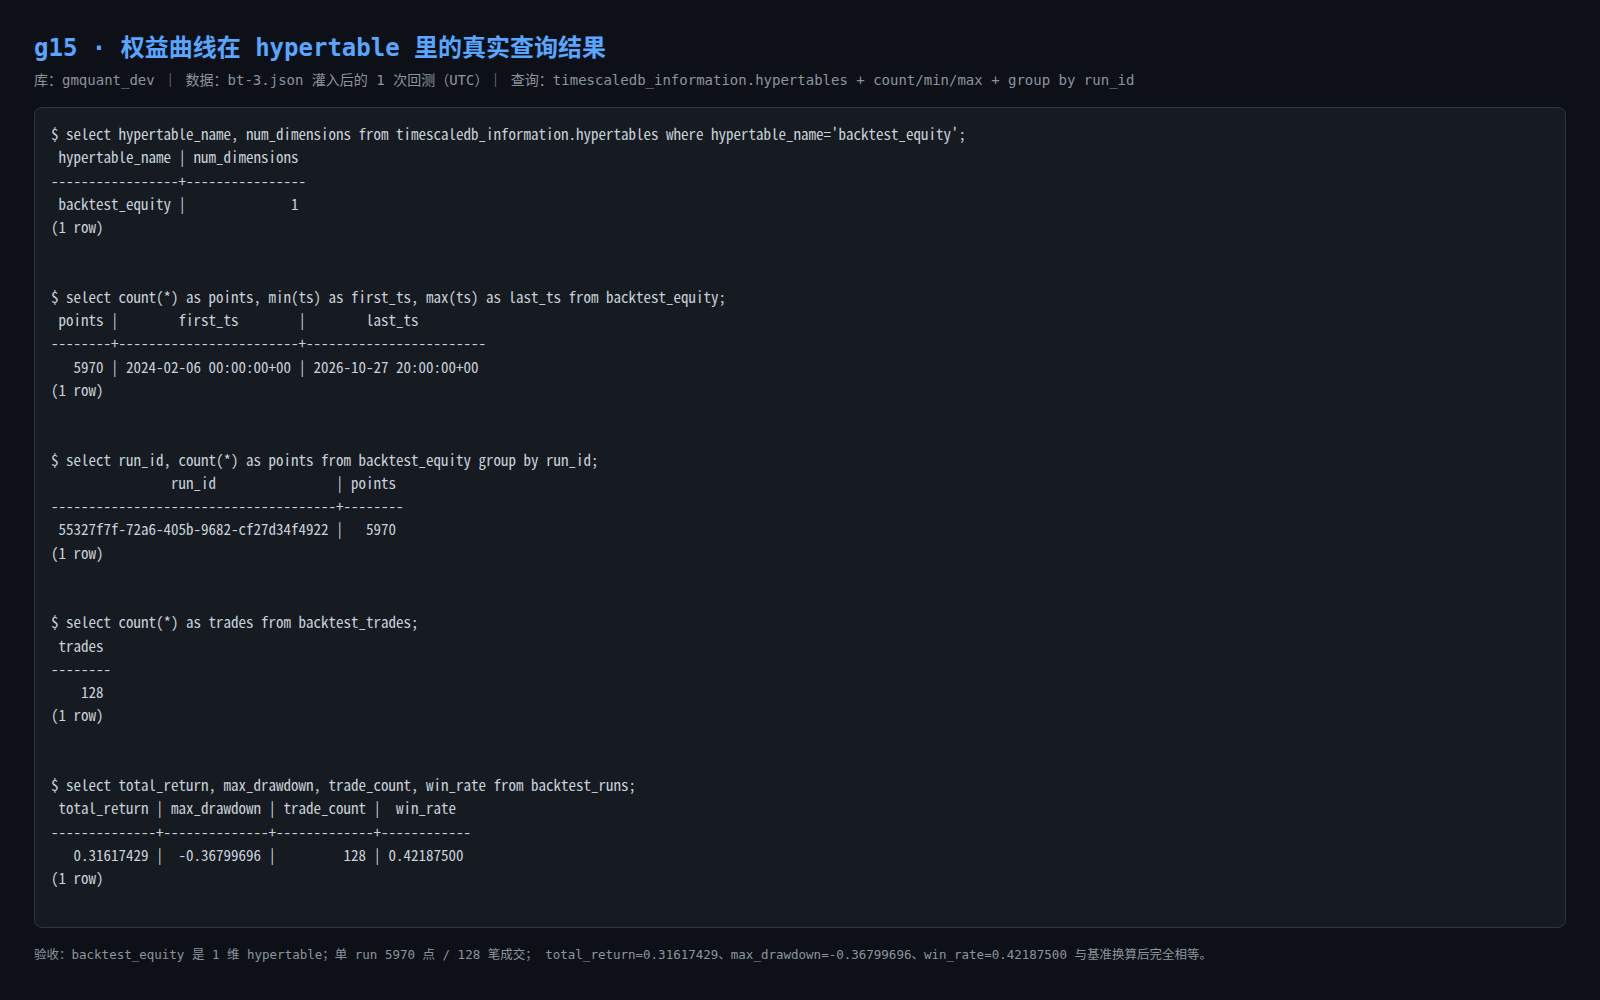
落库看着简单,其实最容易埋雷:金额一旦用浮点存进去,读回来差一点点,几万次回测之后就成了一笔糊涂账。所以全程用十进制定点数,写进去再读出来必须严格相等。回测的三个部分分开存:总结、逐根 K 线的权益曲线、每一笔成交明细。
今晚还有段比写代码更有意思的事。验收要求复现一份事先定好的基准收益,谁都以为照着写就行。可动手前先读那份基准数据本身,发现对它的描述是错的:说是十根快线、三十根慢线、满仓、不止损;真实基准却是二十根快线、六十根慢线、只上九成仓位、带百分之八止损、下一根开盘成交还多一根延迟。
那就别猜了,反推。按读出来的规则从头模拟一遍,一百二十八笔委托的入场时间、出场时间、成交价、成交数量逐笔比对,一百二十八笔全部对上,零差异;最终收益百分之三十一点六一七四,和基准逐位相同。这不是靠调参数凑出来的——参数是从基准自己的成交记录里反推的,收益是规则跑出来的结果。
另一件事是策略代码要能被别人写。别人写的代码不能直接在你机器上跑,所以我们给它造了个笼子:只允许用几个纯做计算的库,别的模块一律不许导入;动态执行、打开文件这类动作直接拒绝,还告诉写代码的人错在第几行。
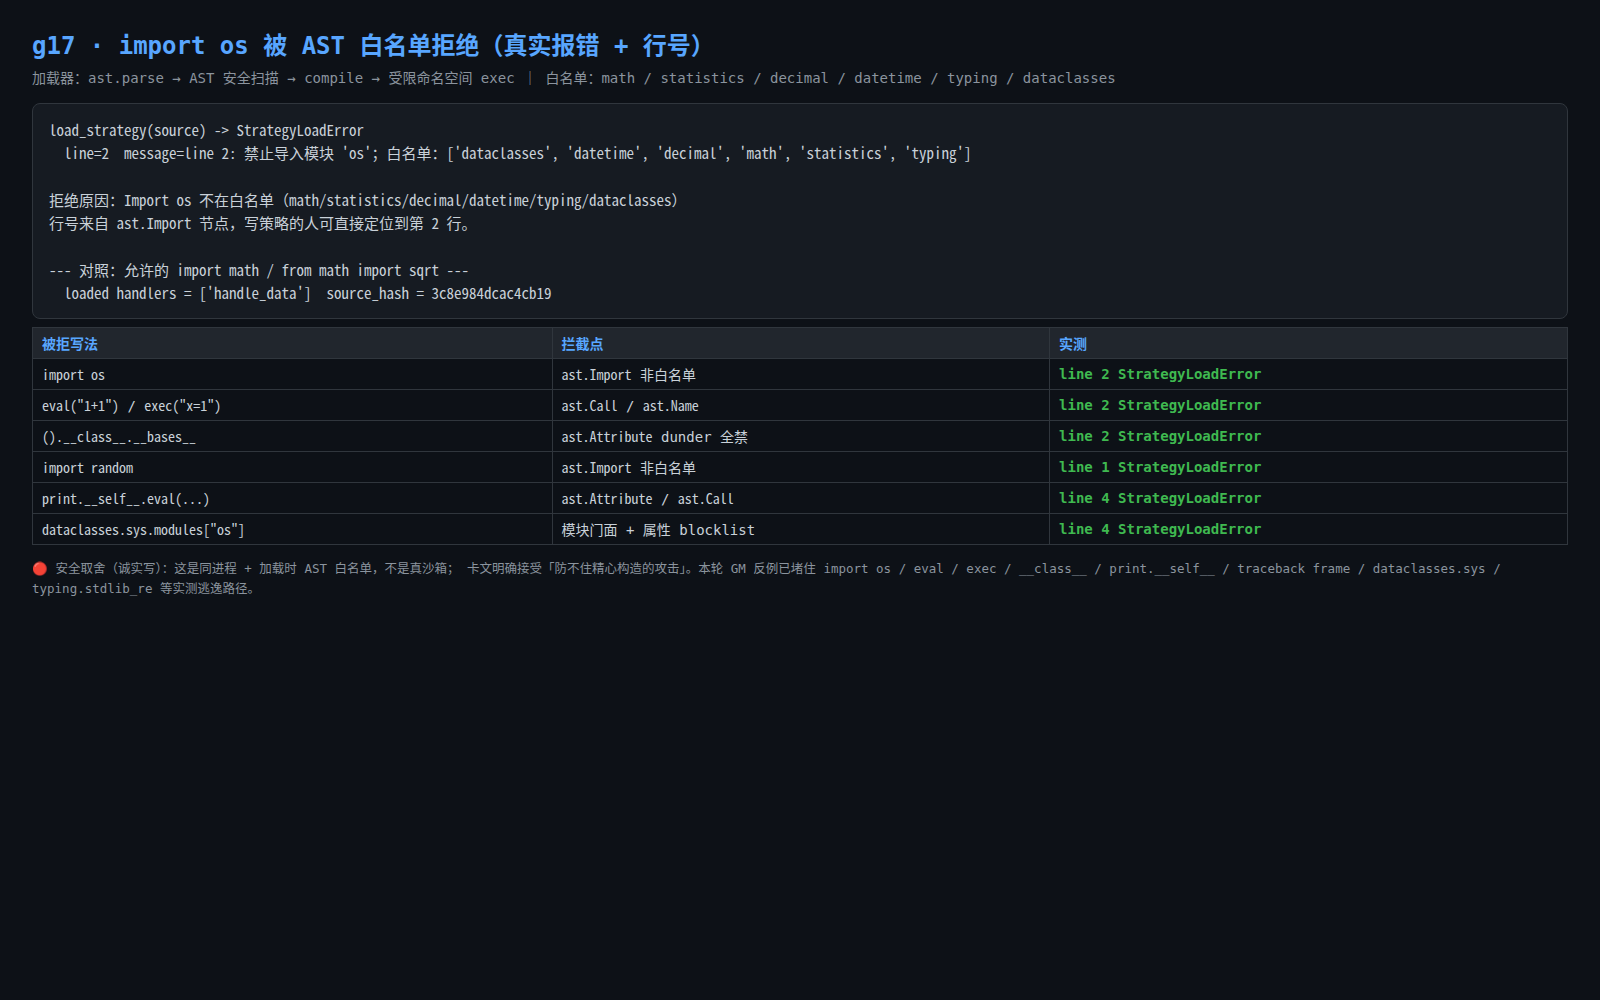
这个笼子是反复撞出来的。第一版放行了几种很隐蔽的翻墙姿势:从内置打印函数的内省属性摸到真正的执行器、从报错堆栈顺着栈帧找到全局变量、从白名单库自己身上翻出系统模块,返工三轮才堵干净。我们没有假装完美——还有一条精心构造才能走通的路径没堵住,照实写进报告。
最后一件事是批量试参数。以前只能一组一组手改手跑,现在可以把参数的取值范围列成一张网格,一次铺开几十组,每组真跑一遍回测,按收益排好序写进数据库,再额外做两件事:看最优参数旁边的邻居表现,以及把历史按时间切成前后两段分别回测。
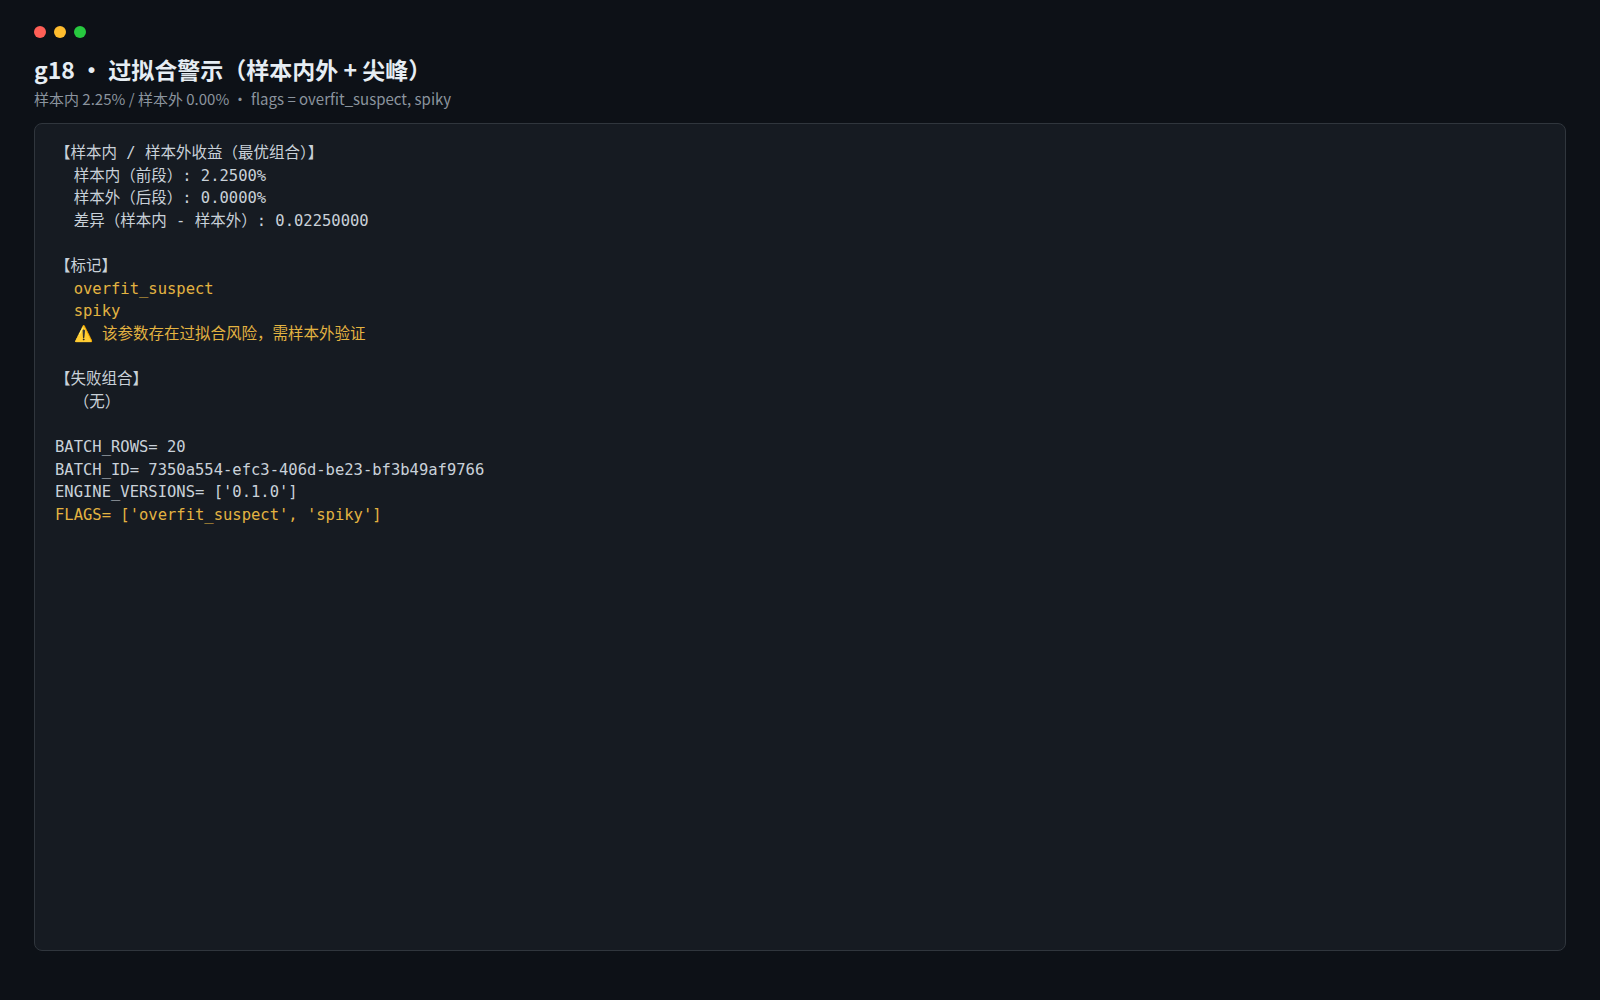
这两件事就是防自欺。排第一的那组参数,邻居一个收益为零、一个是负的,整条曲线是个孤零零的尖峰;切到后段样本外再跑,收益直接归零。系统于是打了两个标签:疑似过拟合、参数敏感。报告里直接写出「这个参数有风险,需要样本外验证」——我们宁可写进去,也不愿事后补一句「可实盘」。
今晚四件事都做完了,测试从三百零八条涨到五百零二条,只涨不跌。在部署环境里重跑一遍全过,数据库和缓存都正常,代码逐文件比对一致。明晚继续把策略执行器和回测引擎接成一条线,再把那份真实基准的逆向复现固化成正式的一关。